
AI API 与开发者工具
Mistral Large 4:能力、架构、价格与部署方式详解
一份基于官方资料核实的 Mistral Large 4 指南,覆盖开放权重 MoE 架构、多模态能力、100 万 token 上下文、API 价格、代码代理和部署取舍。
Mistral Large 4:能力、架构、价格与部署方式详解
Mistral Large 4 是 Mistral AI 推出的开放权重、通用型多模态模型,兼具文本与图像理解、推理、编程、工具调用和 Agent 工作流能力。 它真正值得关注的地方,不只是“一万亿参数”这个醒目的数字,而是把细粒度 Mixture-of-Experts(MoE)架构、100 万 token 上下文窗口、16 亿参数视觉编码器,以及从 API 到私有化部署的选择放进了同一个产品路线中。
本文的结论很明确:如果你的任务涉及长文档、图表和截图理解、代码代理、复杂工具工作流,或者团队重视开放权重、区域推理和部署自主权,Mistral Large 4 值得进入测试名单。但它并不会自动成为所有场景的最佳模型,官方 benchmark 也不能代替真实业务评测。需要比较多个模型或搭建多模型产品时,可以先通过 01Router AI Gateway 将模型选择与应用集成解耦。
本文资料截至 2026 年 10 月 30 日。Mistral Large 4 的发布节奏很快,权重、价格、地区可用性、安全策略和服务限制都可能变化。Mistral 官方公告显示,该模型于 2026 年 10 月 6 日以 public preview 形式发布;官方模型页标注其为 public preview,并采用 Mistral Ecosystem Open Weight License v26.10。
说明:本文插图是用于解释概念的信息科技草图,不代表 Mistral 私有基础设施,也不是模型计算图的真实还原。
目录
- 一句话认识 Mistral Large 4
- 架构:一万亿参数到底意味着什么
- 多模态能力与 100 万 token 上下文
- 编程、Agent 与推理
- 开放权重和部署选择
- API 价格与成本估算
- 如何避免被 benchmark 误导
- 谁适合使用 Mistral Large 4
- 常见问题
- 来源与核实说明
一句话认识 Mistral Large 4
| 问题 | 基于资料的回答 |
|---|---|
| 它是什么? | Mistral AI 的开放权重通用型多模态模型。 |
| 支持什么输入? | 文本和图像,可用于文档、图表、工程图、截图和自然图像理解。 |
| 使用什么架构? | 细粒度 MoE;官方模型页列出总参数 1.05T、激活参数 52B。 |
| 上下文多大? | 官方模型页列出 100 万 token;具体服务可能设置更低限制。 |
| 核心能力是什么? | 指令遵循、推理、编程、视觉理解、工具调用和 Agent 工作流。 |
| 它是开源模型吗? | Mistral 更准确的表述是 open-weight(开放权重),不应直接推断所有训练数据和服务组件都开源。 |
| API 多少钱? | 截至本文核实时,Mistral 官方标准价格页列出输入 $0.70/百万 token、缓存输入 $0.07/百万 token、输出 $2.10/百万 token。上线前应重新核对。 |
| 适合自部署吗? | 只有在模型质量、硬件、许可证、隐私要求和运维预算都匹配时才适合。 |
架构:一万亿参数到底意味着什么
Mistral Large 4 使用细粒度 Mixture-of-Experts 架构。在 dense 模型中,每个 token 通常都会经过完整的参数网络;MoE 模型则会通过路由器,为不同 token 选择少量专家模块。因此,模型可以拥有很大的总容量,但每个 token 的推理路径只激活一部分参数。
官方模型页列出 1.05T 总参数 和 52B 激活参数。“激活”并不代表其余参数没有作用,而是表示一次推理只会选择部分专家。这个差异会影响吞吐、显存规划、路由行为和硬件需求,但它本身不能证明模型一定更便宜、更快或更准确。真实结论仍需要通过你的任务测量。
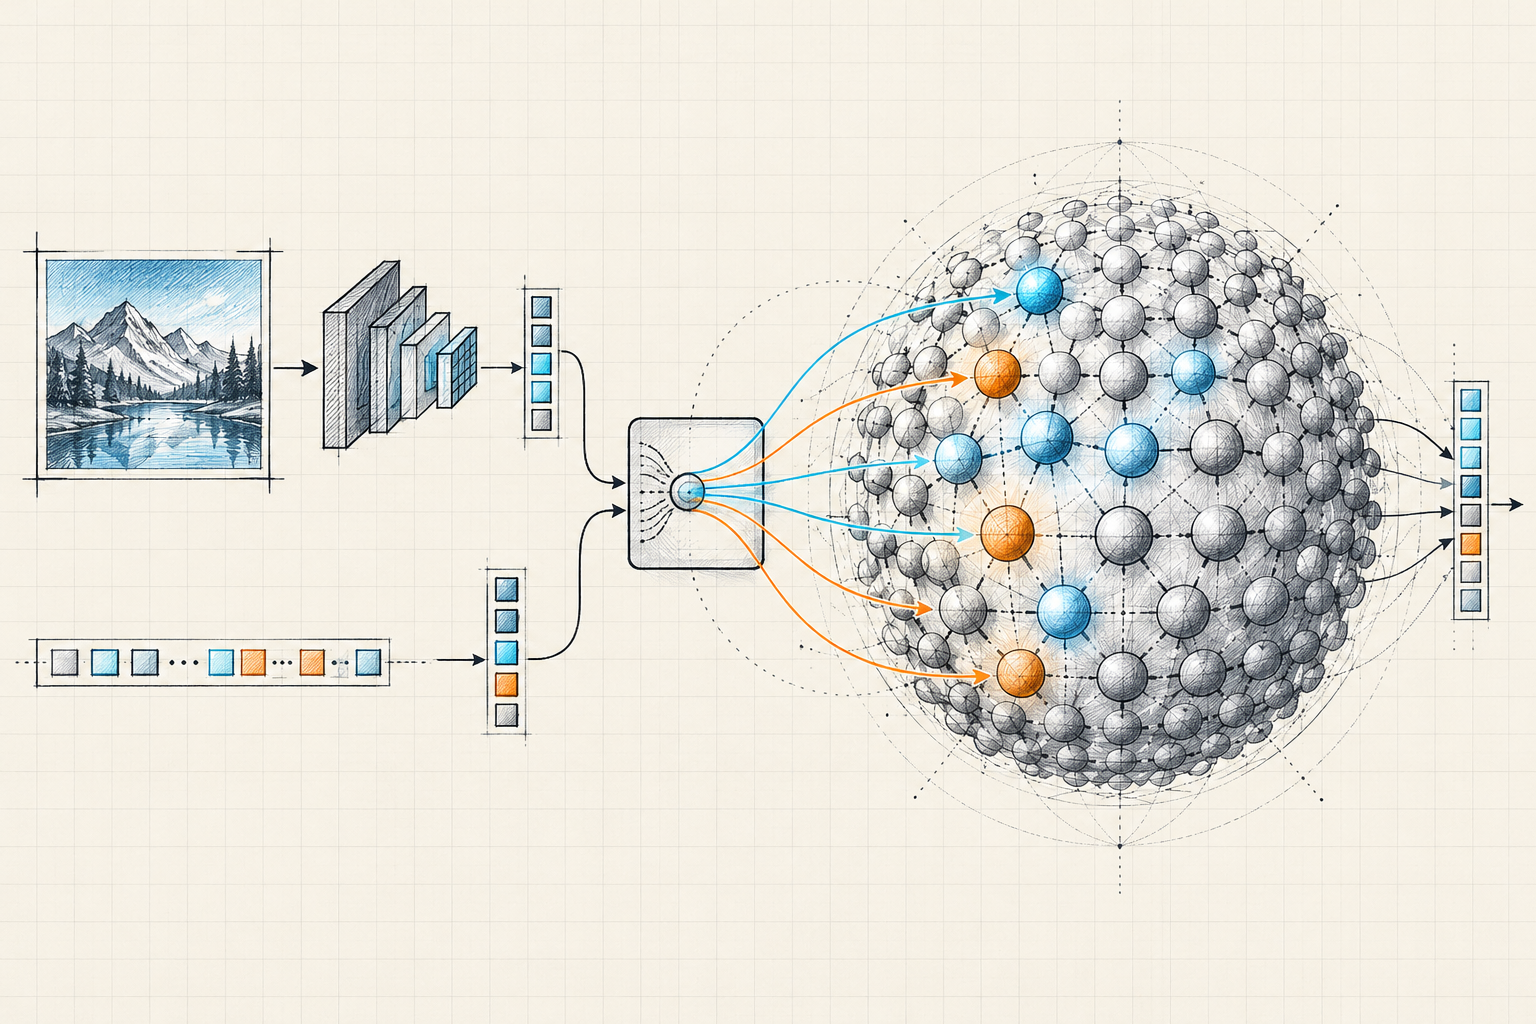
官方页面还列出了 16 亿参数视觉编码器。对开发者来说,这说明图像理解是模型规格的一部分,而不是简单外挂的图片描述功能。但它不代表所有视觉任务都同样可靠。小字号、旋转表格、低分辨率截图、密集工程图和缺少上下文的图片,都应该单独测试。
更有用的工程问题不是“参数够不够大”,而是:它能否以可接受的延迟和成本为你的应用带来足够的能力?实时聊天可能更适合小模型;代码仓库级 Agent、长技术资料分析则可能更重视容量和上下文。benchmark 只能提供方向,不能替你做出这个取舍。
多模态能力与 100 万 token 上下文
Mistral Large 4 面向文本和图像输入,适合尝试以下任务:
- 对多份图表、截图或扫描页面提问;
- 从合同、技术报告中抽取证据;
- 检查工程图并定位需要关注的区域;
- 将图表与文字说明进行交叉分析;
- 把图像输入与代码或工具调用任务结合起来。
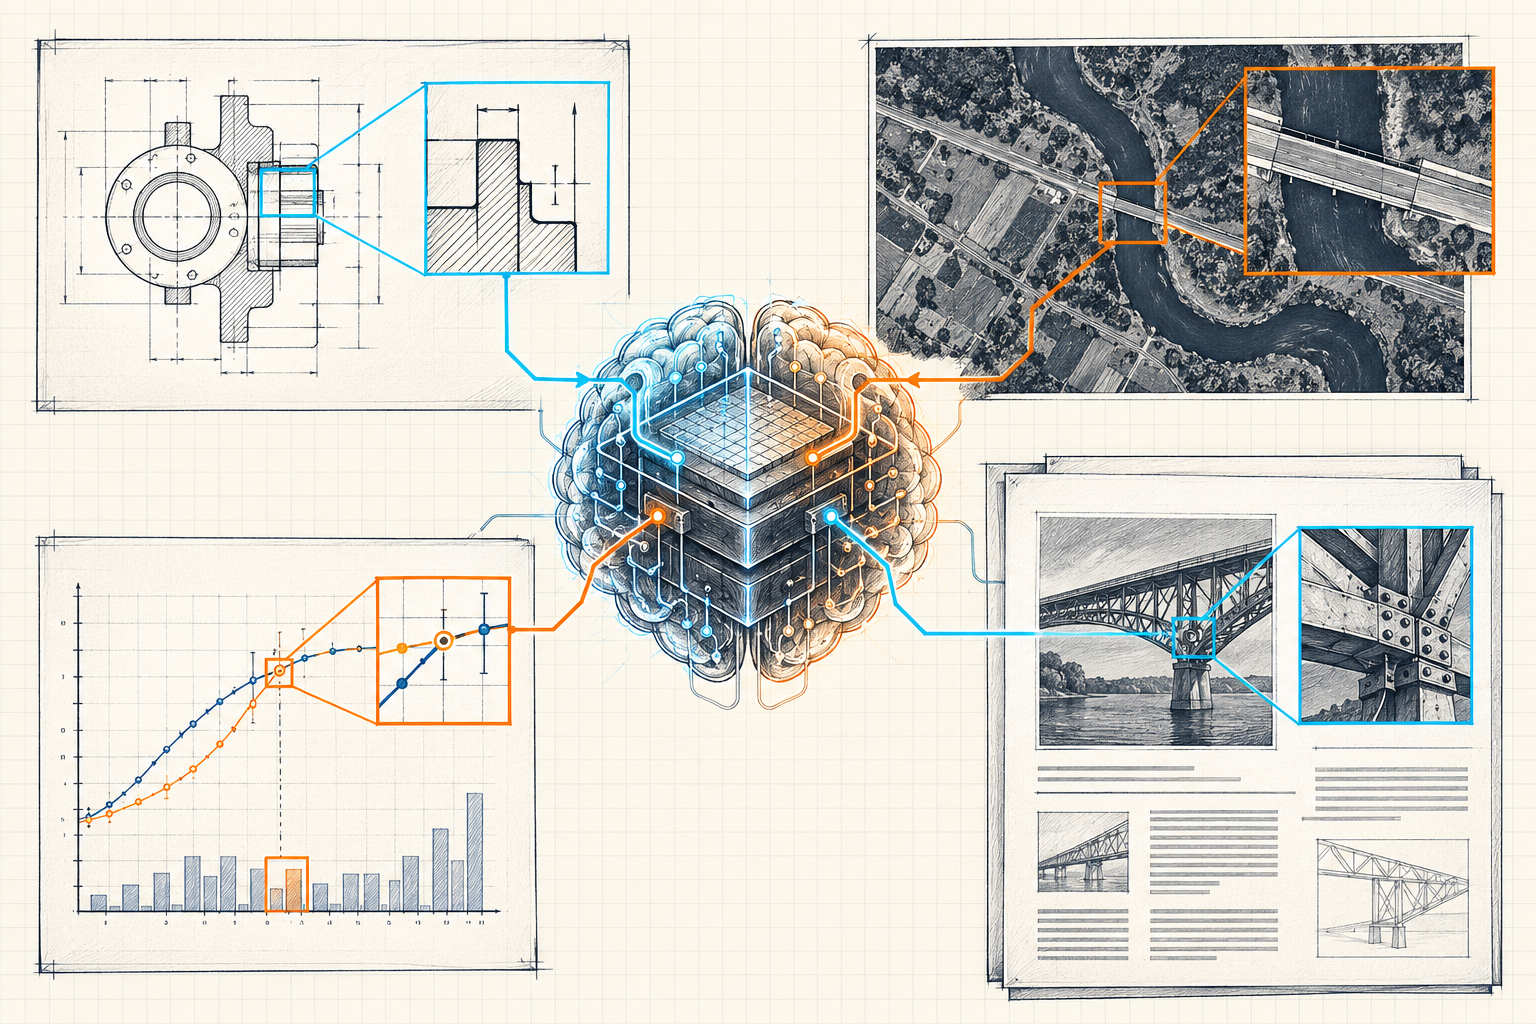
官方模型页列出 100 万 token 上下文窗口。但“能接收很长输入”不等于“对每个位置都同样可靠”。模型可能接受一大段文本,却遗漏中间位置的关键事实。因此评测时要改变文档长度、术语重复率、表格密度、图片分辨率和答案所在位置,同时记录准确率以及需要提供多少上下文才能稳定回答。
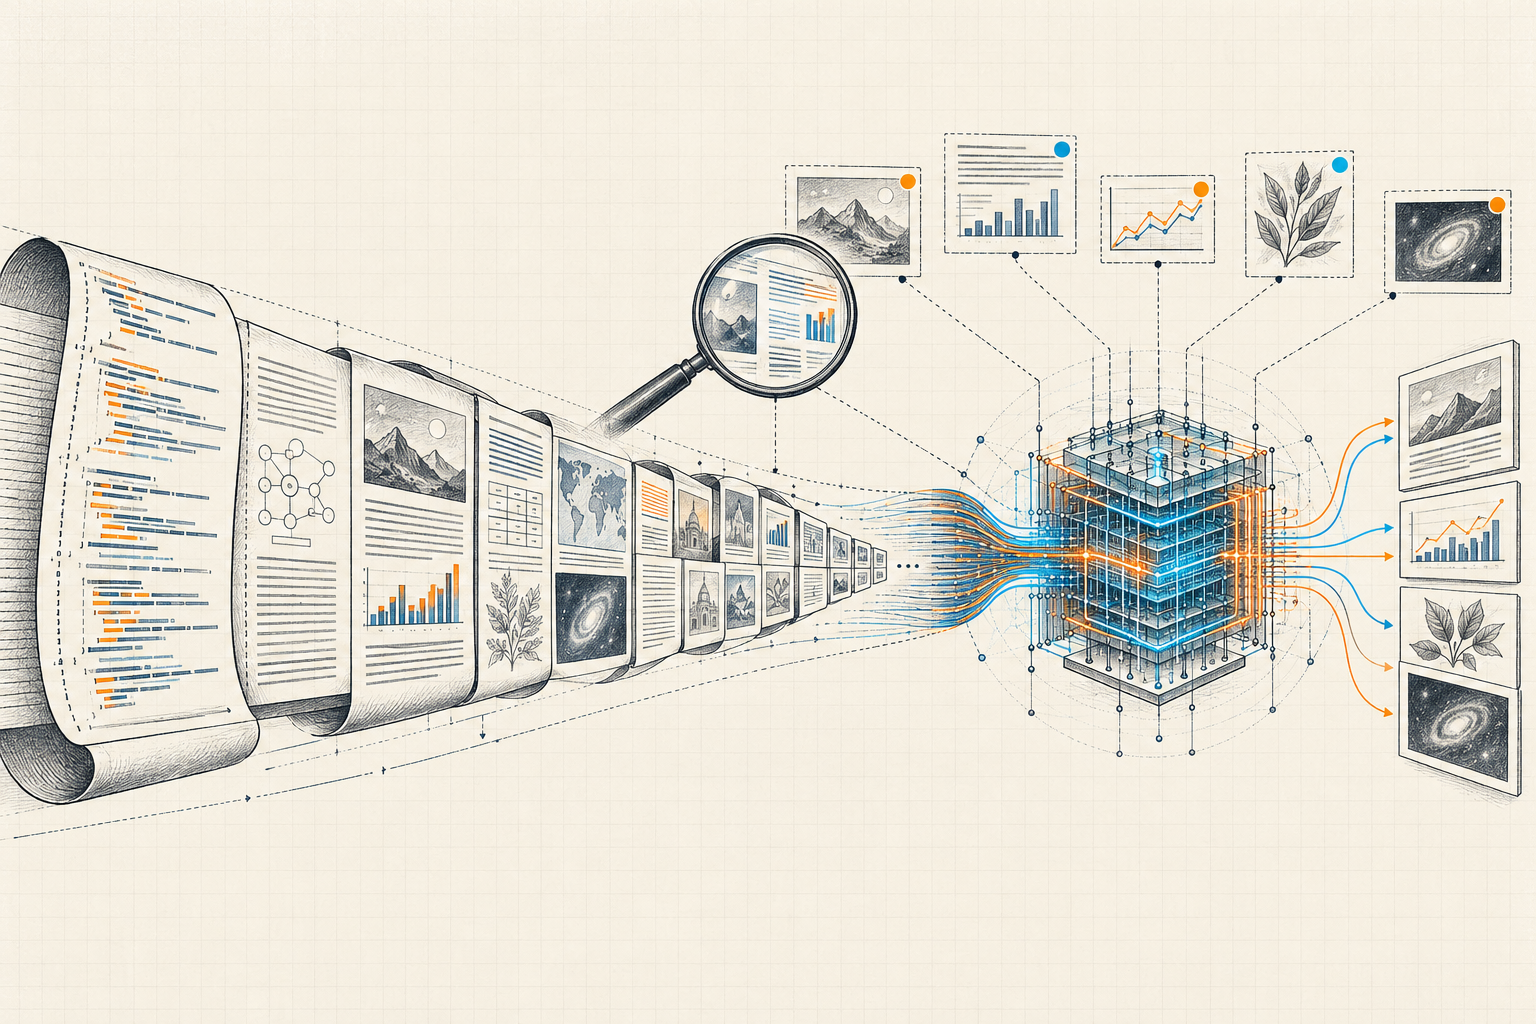
参考站点 mistrallarge4.com 特别提醒了一个容易混淆的差异:模型理论上的 100 万 token,不等于公开 Playground 的输入限制。任何托管服务都可能额外设置请求体、文件大小、输出 token、对话轮数和速率限制。
生产系统不应把所有文件无差别塞进每次请求。更稳妥的路径是先做检索、分段和页码引用,再要求模型给出证据位置;随后再测试更长上下文是否真的减少检索错误,并权衡 token 成本与延迟。长上下文是能力,不是信息架构的替代品。
编程、Agent 与推理
Mistral 将 Large 4 定位为适合编程、Agent 工作流和复杂专业任务的模型。官方公告报告了 DeepSWE、SWE-Atlas-QnA、Terminal-Bench 4、AutomationBench 和 AA-Briefcase 等评测,也介绍了金融、法律、工程、制造和网络安全等场景的评估。
这些结果值得参考,但应明确它们是 Mistral 公布的评测结果,不是所有用户环境下的统一排名。分数会受到 prompt、工具权限、版本、评分方式、超时设置和推理预算影响。公告也说明,随着模型继续完善,后续会公开更多 benchmark 和 post-training 细节。
对代码 Agent 来说,真正有价值的是仓库理解、长上下文、工具调用和多步骤工作能力的组合。推荐的 Agent 循环包括:
- 读取任务与仓库约束,明确假设;
- 只读取当前步骤需要的文件;
- 做小范围修改;
- 运行测试、lint 或类型检查;
- 检查 diff 和最终解释;
- 在有风险的操作前保留人工批准环节。
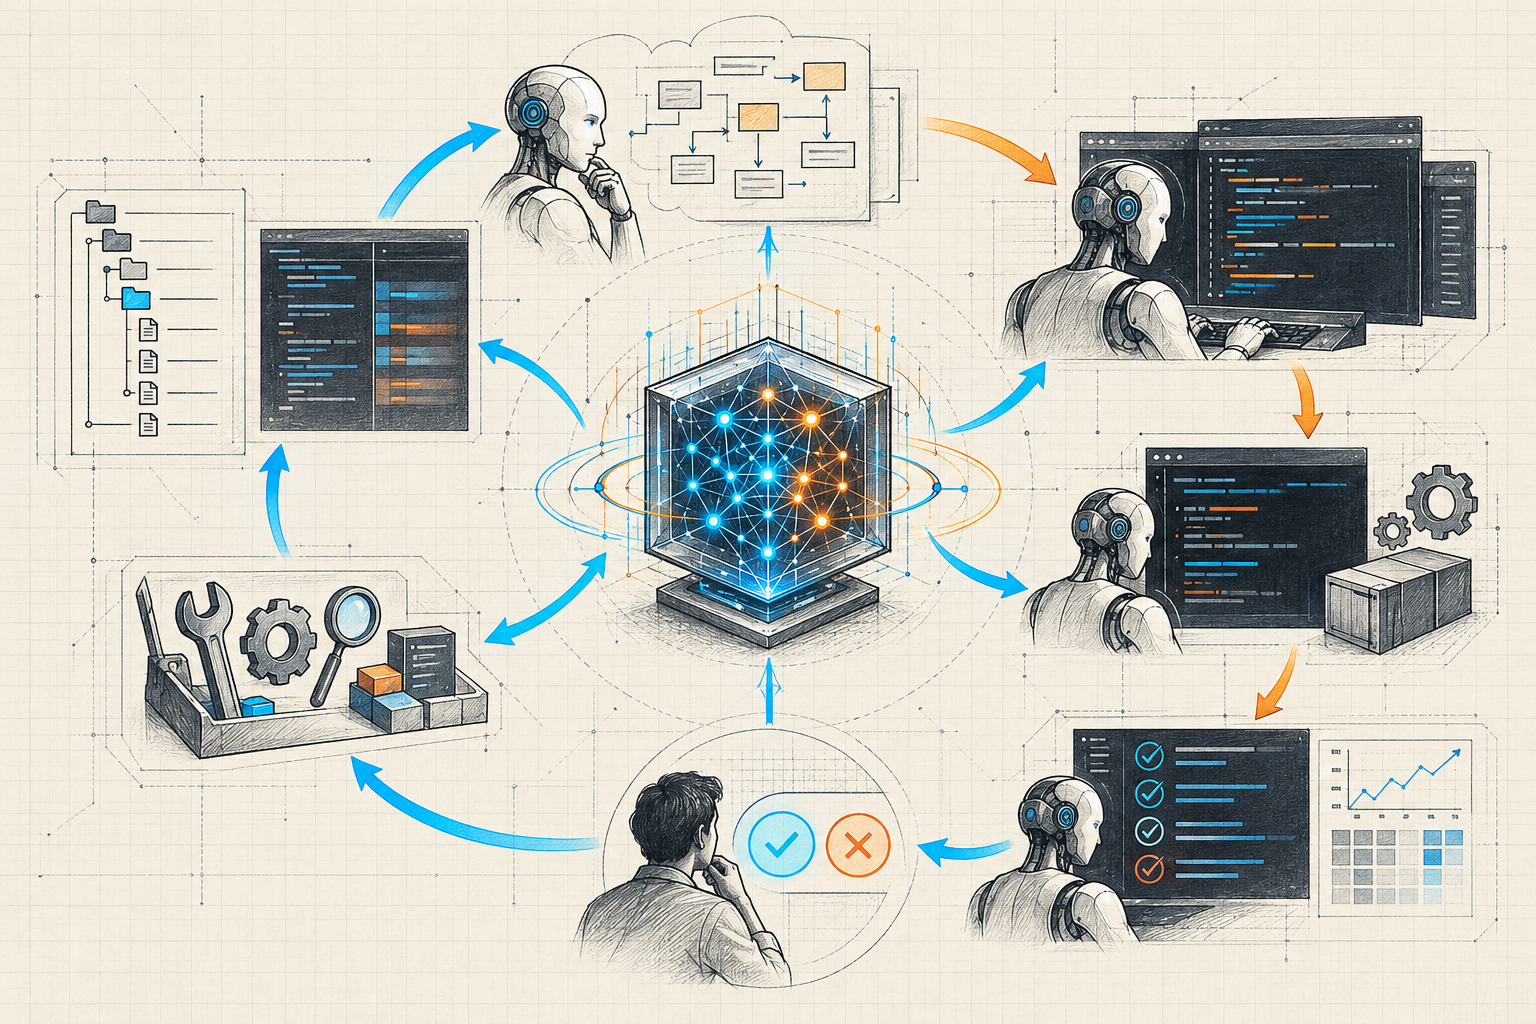
因此,评测时不要只问“它会不会写代码”,而要统计从任务开始到正确 patch 的总耗时、工具调用次数、回滚率、测试通过率和最终说明质量。如果产品支持可调节的 reasoning effort,还应同时记录首 token 延迟、完成延迟和输出 token;对简单抽取任务,更多推理可能只是增加成本。
开放权重和部署选择
Mistral 将 Large 4 称为 open-weight 模型。开放权重可以让企业更好地控制推理位置、审计方式,以及在托管平台政策或可用性变化时的连续性。但它不会自动解决许可证、GPU 资源、服务安全、依赖升级、监控和内容安全问题。
官方发布材料把 Large 4 放在欧洲基础设施与 AI 主权的路线中,介绍了 Mistral 自有欧洲基础设施、多地区服务和欧洲法律下的部署选择。对于有数据驻留和业务连续性要求的组织,这些信息很重要;但“在欧洲”并不等于完整的安全评估。还要确认日志、支持数据、备份、遥测和分包商的位置。
| 部署路径 | 适合情况 | 主要风险 |
|---|---|---|
| Mistral 托管 API | 需要快速接入和弹性容量。 | 供应商限制、价格变化和数据治理审查。 |
| 区域或优先级托管推理 | 需要区域控制或更可预测的服务行为。 | 价格更高,或地区和模型可用性有限。 |
| 私有云 | 需要网络和权限边界,同时能运营 GPU。 | 容量规划和运维复杂度。 |
| 本地部署 | 数据不能离开控制范围,且已有硬件团队。 | 资本成本、服务升级、安全和利用率。 |
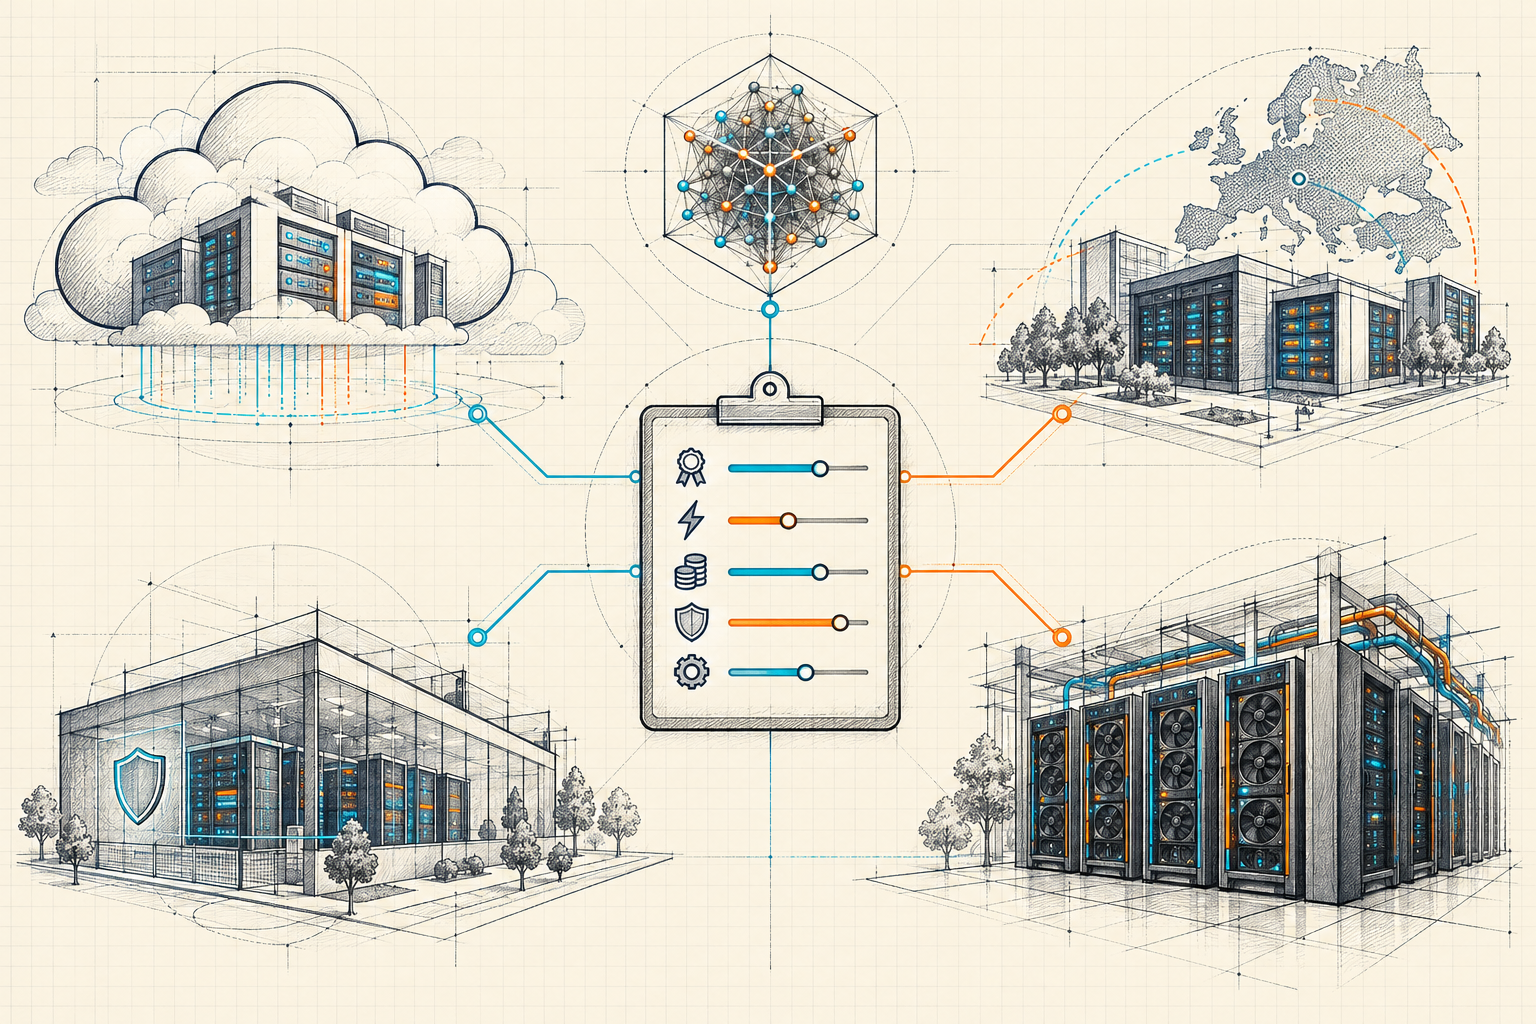
不要先决定部署方式,再寻找业务理由。可以先使用托管 API 完成质量与成本验证;当隐私、连续性或合规要求明确后,再迁移到私有云或本地。混合架构也很常见:敏感任务留在受控环境,低风险任务使用弹性托管推理。
API 价格与成本估算
截至本文核实,Mistral 官方 API 价格页列出 Large 4 的标准价格为:输入 $0.70/百万 token、缓存输入 $0.07/百万 token、输出 $2.10/百万 token。模型页面还列出 100 万 token 上下文、结构化输出、函数调用、文档问答、批处理、Agent 和内置工具等能力。具体功能和价格可能随地区、批处理或服务等级变化,正式报价前请查看实时页面。
文本请求可以先用下式估算:
成本 = 输入 token × 0.70 / 1,000,000
     + 缓存输入 token × 0.07 / 1,000,000
     + 输出 token × 2.10 / 1,000,000
这只是第一步。生产成本还应加入图片处理、工具调用、重试、审核、存储、向量检索、可观测性和人工复核。对于长上下文应用,更应该关注“每个被接受结果的成本”,而不是单次请求价格。若用户需要三次生成后才接受一次结果,前两次成本也应计入。
缓存同样要单独测量。稳定的 system prompt、重复的政策文本或共享仓库前缀可能可以缓存,但前提是服务的缓存语义和 cache key 与请求模式匹配。记录缓存命中率、输入 token、输出 token 和延迟,才能判断长上下文是否真的被复用。
如果成本可预测性很重要,请为每次 Agent 运行设置预估和硬预算,不允许模型任意选择工具、文件或递归子 Agent。可以将 01Router 定价页 作为内部比较入口,评估单模型接入与多模型路由的成本差异。
如何避免被 benchmark 误导
在做采购或上线决定前,建议用一周建立一个小型、可重复的评测集。
1. 建立任务矩阵
至少包含普通问答、长文档、视觉问题、代码任务和工具工作流五类样本。每类都放入简单、典型和容易失败的案例,并冻结测试集,避免 prompt 改动掩盖回归。
2. 先定义正确标准
抽取任务用 schema 校验;代码任务运行测试并检查 diff;文档问答要求证据位置;图像理解标出需要识别的区域或数字。只依赖人工偏好会让结论过于主观。
3. 测完整链路
记录首 token 延迟、最终延迟、输入输出 token、缓存命中、工具调用、重试、错误、拒答和成本。分别测试冷启动与热状态。质量更高但延迟翻倍的模型,可能适合异步后台任务,却不适合实时助手。
4. 测试安全边界
把文档中的 prompt injection、恶意工具参数、敏感数据、不安全代码和越权请求放进测试集。开放权重会带来控制力,也会把更多安全责任交给部署者。工具必须有服务端校验和最小权限凭据。
5. 与基线比较
基线可以是当前模型、更小的 Mistral 模型或一个确定性系统。真正的问题不是 Large 4 单独看起来多强,而是它是否带来了足够大的结果改进,来抵消额外的成本、硬件、延迟和运维风险。
谁适合使用 Mistral Large 4
如果你的需求同时包含以下几项,Large 4 值得优先测试:
- 文档、图表、截图和工程图的多模态输入;
- 仓库级或资料库级长上下文分析;
- 在同一模型中完成编程与工具调用;
- 开放权重或自部署要求;
- 区域、私有或主权推理要求;
- 需要评测普通回答与长流程 Agent 的统一模型。
如果你的场景只需要极低延迟、小型部署、简单分类,或者已有成熟的垂直模型,那么 Large 4 未必是最佳第一选择。更现实的架构通常是模型路由:复杂推理、视觉定位和规划交给大模型,常规转换、分类和嵌入交给更便宜的专用模型。
常见问题
Mistral Large 4 是开源模型吗?
Mistral 使用的是 open-weight,官方模型页列出 Mistral Ecosystem Open Weight License v26.10。更准确的说法是“开放权重模型”。在进行商业部署前,应阅读许可证和服务条款,不要默认训练数据、工具链和所有用途都拥有相同自由度。
Mistral Large 4 支持多模态吗?
支持。官方模型页将其定义为通用型多模态模型,并列出 16 亿参数视觉编码器。具体项目仍应针对实际图片、文档格式和清晰度测试。
它真的支持 100 万 token 上下文吗?
官方模型页列出 100 万 token,但托管 Playground、API 网关、SDK 或账号可能设置更低的请求和输出限制。应确认实际服务限制,并测试长上下文召回能力。
当前 API 价格是多少?
本文核实时,官方价格页列出输入 $0.70/百万 token、缓存输入 $0.07/百万 token、输出 $2.10/百万 token。地区、服务等级、批处理和供应商可能造成差异,预算前请重新核对。
它适合代码 Agent 吗?
它面向编程和 Agent 工作流,并且 Mistral 报告了多个相关评测结果。但最终效果会由工具、仓库规模、测试体系、审批规则和你的 Agent 循环共同决定。
是否应该自部署?
如果隐私、连续性或控制权的价值高于 GPU 与运维成本,自部署可能合理。否则建议先用托管服务完成质量、延迟和成本验证,再决定是否建设私有基础设施。
它能替代其他所有模型吗?
不能。通用旗舰模型可以覆盖很多任务,但 OCR、嵌入、语音、审核和简单结构化转换可能更适合专用模型。应该用评测和路由,而不是“一模型解决一切”的理念。
最好的试用方法是什么?
从一组真实、可验证的任务开始,要求模型提供证据,检查工具调用,并与现有基线比较质量、延迟和成本。随着模型生态变化,也可以通过 01Router AI 研究文章 持续了解新的模型与 API。
来源与核实说明
- Mistral AI:Introducing Mistral Large 4:发布时间、public preview、架构、能力、评测、基础设施和路线图。
- Mistral Docs:Mistral Large 4 模型页:1.05T 总参数、52B 激活参数、16 亿视觉编码器、100 万 token 上下文、功能、许可证和模型价格。
- Mistral Docs:API pricing:本文使用的官方标准 token 价格。
- Mistral API reference:聊天接口字段、流式输出、工具、JSON 输出和 SDK 示例。
- Mistral Large 4 参考站点:Playground 限制、实践用法和非官方产品化介绍。模型事实以 Mistral 官方来源为准。
本文数字和功能描述于 2026 年 10 月 30 日复核。Mistral Large 4 仍在快速演进;将本文作为实现依据前,请重新确认模型可用性、许可证、价格、安全行为和服务限制。